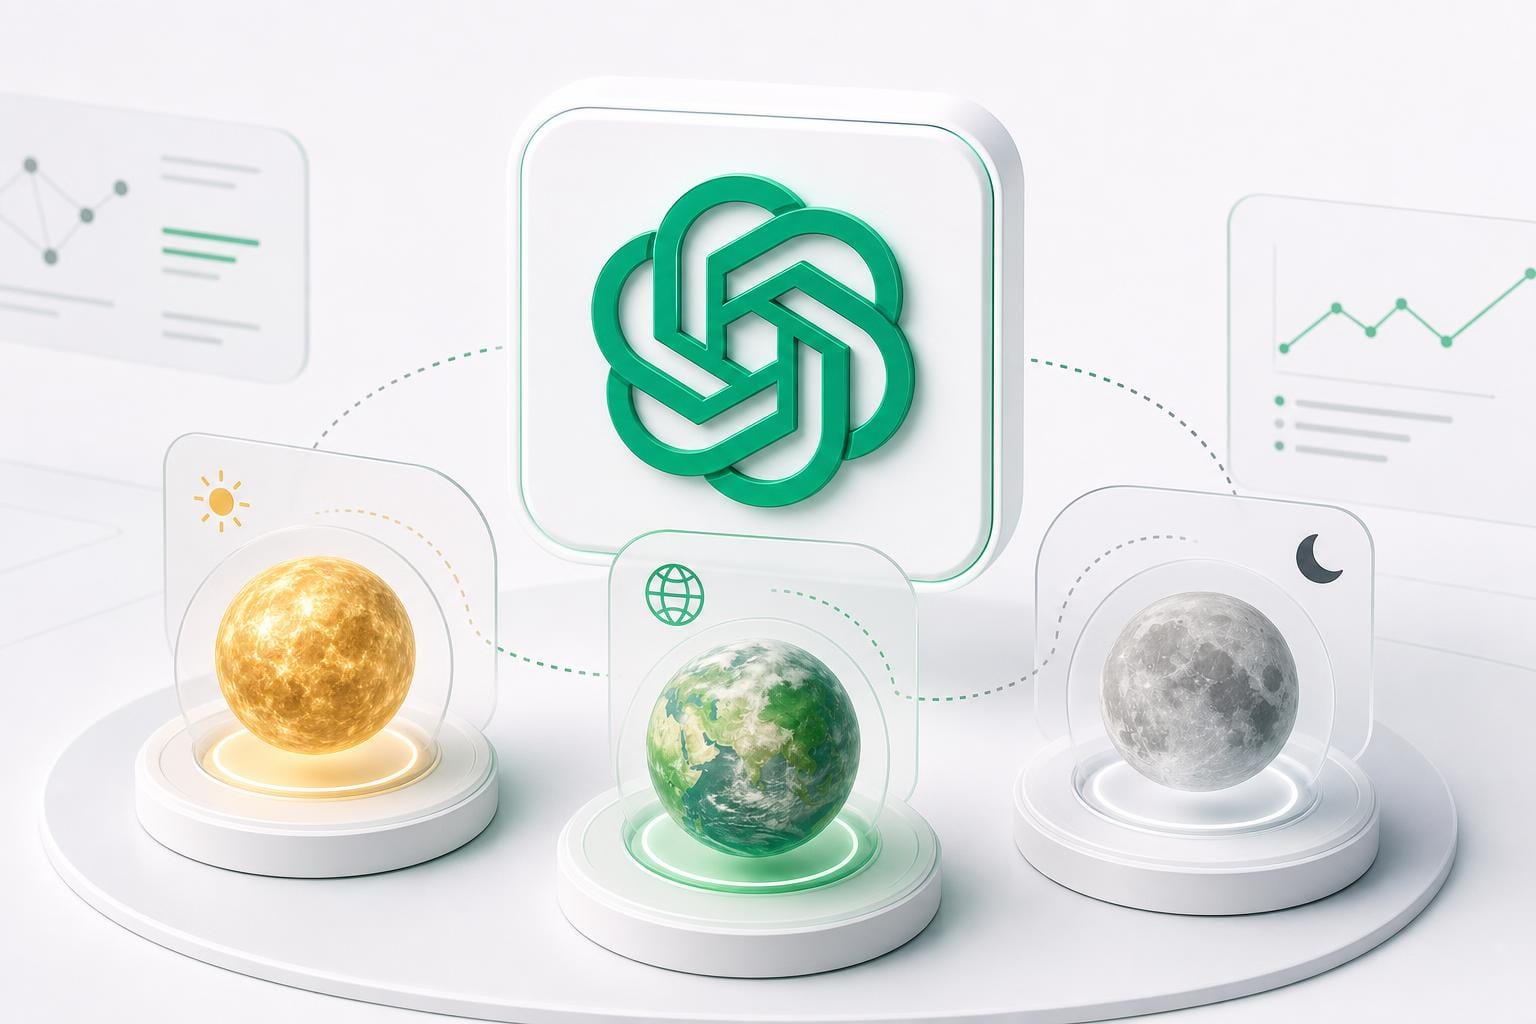
OpenAI erweitert seine Modellfamilie mit GPT-5.6 um drei Varianten für unterschiedliche Anforderungen. Im Mittelpunkt steht Sol als leistungsstärkstes Modell, ergänzt durch Terra und Luna für günstigere und schnellere KI-Anwendungen. Für Nutzer bedeutet das vor allem: Je nach Aufgabe steht das passende Modell für maximale Leistung, ein ausgewogenes Verhältnis aus Kosten und Geschwindigkeit oder besonders günstige KI-Anfragen zur Verfügung.
Was GPT-5.6 für Nutzer ändert
GPT-5.6 besteht aus Sol, Terra und Luna. Die Modellfamilie soll komplexe Aufgaben mit weniger Token, kürzeren Antwortzeiten und niedrigeren Gesamtkosten erledigen. Ziel ist es, pro Anfrage mehr nutzbare Arbeit zu leisten, statt lediglich längere Antworten zu erzeugen.
Sol ist für schwierige Aufgaben gedacht, Terra für einen Kompromiss aus Leistung und Kosten, Luna für schnelle und einfache Anfragen.
Für Anwender ist weniger der Modellname wichtig als der passende Einsatz. Komplexe Texte, Softwareprojekte, Datenanalyse und mehrstufige Aufgaben profitieren am ehesten von Sol. Kurze E-Mails, einfache Zusammenfassungen oder schnelle Antworten brauchen meist kein Spitzenmodell.
- Sol: sinnvoll für anspruchsvolle Arbeit, Programmierung und Aufgaben mit mehreren Schritten.
- Terra: geeignet, wenn Leistung, Geschwindigkeit und Kosten ausgewogen sein sollen.
- Luna: passend für einfache Alltagsfragen, kurze Texte und schnelle Standardaufgaben.
OpenAI stellt GPT-5.6 in ChatGPT, Codex und der API bereit. Für Entwickler ist GPT-5.6 Terra zusätzlich als eigenes API-Modell dokumentiert.
Wie sich die Konkurrenz einordnet
GPT-5.6 erscheint in einem Markt, in dem mehrere Anbieter gleichzeitig auf leistungsfähigere und günstigere KI-Modelle setzen. Anders als früher steht dabei nicht mehr nur die maximale Leistung im Vordergrund. Die Anbieter versuchen zunehmend, bessere Ergebnisse bei geringerem Zeit- und Kostenaufwand zu erzielen.
Anthropic positioniert Claude Fable als besonders leistungsfähiges Modell für schwierige Denk- und Agentenaufgaben.
xAI führt mit Grok 4.5 ein Modell für Coding, Agenten und Wissensarbeit. Die Einordnung hängt stark davon ab, ob Nutzer eher maximale Leistung, niedrige API-Kosten oder schnelle Antworten brauchen.
Der gemeinsame Trend ist klar: Die großen KI-Anbieter entwickeln ihre Modelle zunehmend zu Arbeitsassistenten weiter. Statt nur Fragen zu beantworten, sollen sie recherchieren, programmieren, Dateien verarbeiten und längere Arbeitsabläufe möglichst selbstständig erledigen.
Benchmarks bieten eine erste Orientierung, ersetzen aber keine eigenen Tests. Aufgaben wie Coding, Recherche, lange Arbeitsabläufe oder kreative Textarbeit können je nach Modell sehr unterschiedlich ausfallen.
Welche Modellwahl sinnvoll ist
Für die meisten Nutzer ist ein einfaches Prinzip hilfreich: Das stärkste Modell lohnt sich, wenn die Aufgabe teuer, lang oder fehleranfällig ist. Für kurze Routineaufgaben genügt ein günstigeres Modell.
- Schwierige Aufgaben: Sol oder Fable testen, vor allem bei längeren Projekten und komplexer Programmierung.
- Kostenbewusste Nutzung: Grok 4.5, Terra oder Luna prüfen, wenn viele Anfragen anfallen.
- Einfache Alltagstexte: kleinere Modelle reichen oft aus und sparen Kosten.
Die wichtigste Entscheidung bleibt der konkrete Anwendungsfall. Ein Modell kann in Benchmarks stark wirken und trotzdem bei einer bestimmten Aufgabe schlechter passen. Wer regelmäßig mit KI arbeitet, sollte daher kurze eigene Tests mit realistischen Aufgaben durchführen.